
Ein guter KI-Bildprompt ist eine Spezifikation, kein Wunsch. Die zuverlässige Formel: Nennen Sie das Motiv präzise, geben Sie den Stil klar an und fügen Sie dann die konkreten Details hinzu – Beleuchtung, Kamera, Farbpalette, Komposition –, die das Modell sonst raten würde. Alles in diesem Leitfaden baut auf dieser Struktur auf, mit Vorher-Nachher-Beispielen, die Sie mit Ihren eigenen Prompts vergleichen können. Die Beispiele gehen von GLM-Image aus, dem Modell von GLMImage, die Methode lässt sich jedoch auf jeden Generator übertragen.
Die zentrale Erkenntnis: Ein Prompt ist eine Reihe von Entscheidungen. Jedes Detail, das Sie unspezifiziert lassen, entscheidet das Modell für Sie, und seine Standardwerte sind per Definition durchschnittlich. Generische Ergebnisse sind fast nie zuerst ein Modellproblem – sie sind zuerst ein Problem unspezifizierter Prompts.
<!--IMG: The same subject generated from a vague prompt versus a structured, detailed prompt-->
Warum scheitern die meisten KI-Bildprompts?
Sie sind zu unspezifisch. "A coffee shop" enthält keine Entscheidung, die ein Modell nutzen kann: keine Epoche, kein Land, keine Tageszeit, kein Objektiv, keine Stimmung. Das Modell löst jede Mehrdeutigkeit mit seinem Trainingsdurchschnitt auf, und Durchschnitte sehen aus wie alles und nichts. Das Ergebnis wirkt generisch, weil es buchstäblich ein Durchschnitt ist.
Drei erschwerende Gewohnheiten machen es noch schlimmer. Das Anhäufen von Stil-Keywords ohne ein Motiv ("masterpiece, 8K, trending on artstation, cinematic") gibt dem Modell Politur-Vokabular, aber nichts zum Polieren. Widersprüche ("minimalist, ornate, busy") spalten die Aufmerksamkeit des Modells in Rauschen. Und das Fordern von langem Text im Bild ("poster with the full event schedule") beauftragt das Modell mit dem Textsatz, was nicht die Stärke irgendeines Generators ist — kurze Phrasen sind der zuverlässige Bereich.
Nichts davon bedeutet, mehr Wörter zu schreiben. Es bedeutet, Wörter zu schreiben, die jeweils genau eine Entscheidung erzwingen.
Die Struktur hinter Prompts, die funktionieren
Drei Blöcke, in dieser Reihenfolge:
[Subjekt + Aktion] + [Stil / Medium] + [Konkrete Details:
Beleuchtung, Kamera oder Standpunkt, Farbpalette, Hintergrund, Komposition]
Subjekt plus Aktion beantwortet „was ist das für ein Bild und was geschieht“. Füge die Details hinzu, die dir wichtig sind – Alter, Material, Umgebung, Epoche –, denn sie werden nicht inferiert.
Stil oder Medium beantwortet „was ist das für ein Bild als“. Fotorealistisch, redaktionelles Foto, Aquarellmalerei, flache Vektorgrafik, isometrische Concept Art. Eine klare Wahl ist besser als drei vermischte.
Konkrete Details sind der Ort, an dem Qualität entsteht. Beleuchtung („goldene Stunde von links“, „Studio-Weichbox mit subtiler Randbeleuchtung“), Standpunkt („85mm-Porträtobjektiv auf Augenhöhe“, „niedriger Weitwinkel“), Farbpalette („gedämpfte Erdtöne“, „marineblau und Messing“), Hintergrund („sauberer Verlauf“, „verschwommene Osaka-Straße bei Nacht“), Komposition („Subjekt im linken Drittel“, „zentriert, symmetrisch“). Jeder Satz nimmt eine Freiheitsgrad.
Ein Beispiel, Block für Block:
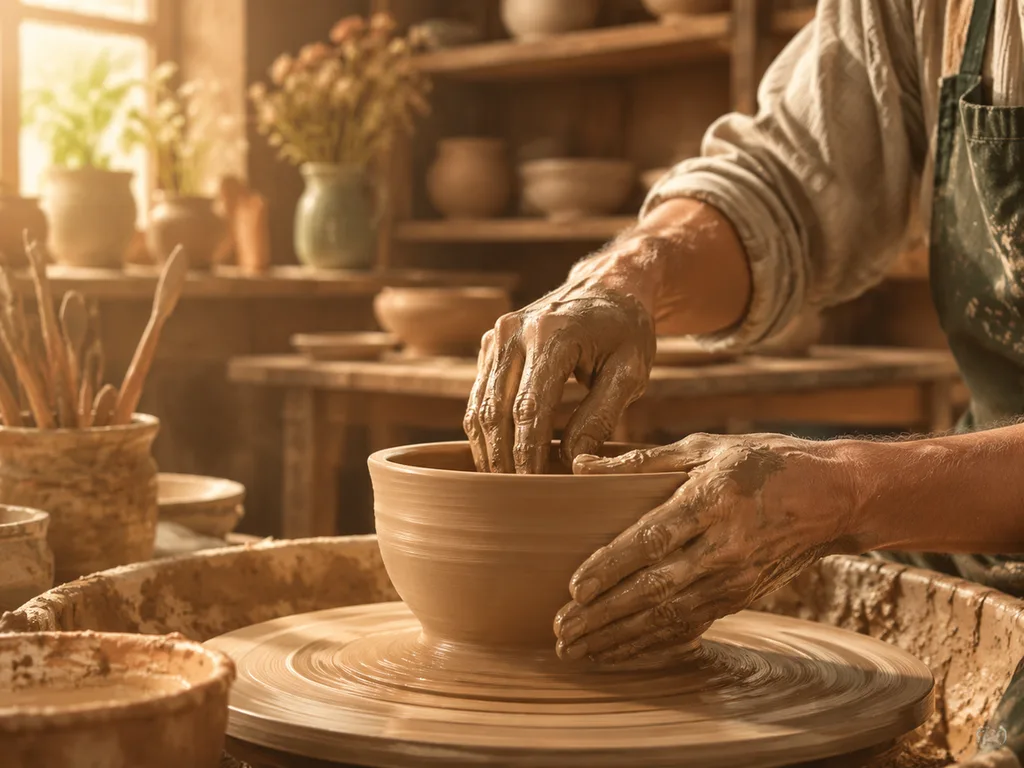
Die Hände eines Keramikers, die eine Tonschüssel auf einer Töpferscheibe formen  ← Subjekt + Aktion
Dokumentarische Fotografie                                                       ← Stil
Warmes Fensterlicht von links, flache Schärfentiefe,
tonbestäubte Schürze, verschwommene Werkstattregale im Hintergrund  ← Details
Einunddreißig Wörter, und jedes einzelne erfüllt einen Zweck.
Schwach: "a wolf in the forest."
Analyse: Kein Stil, kein Licht, keine Stimmung — der Wald ist einfach der durchschnittliche Wald des Modells.
Fixed:
A gray wolf standing alert on a moss-covered rock in a misty
pine forest at dawn, wildlife photography, 300mm telephoto
compression, soft diffused fog, muted greens and grays,
sharp focus on the eyes
Warum es funktioniert: Die Wahl von Nebel und Teleobjektiv allein verwandelt „ein Foto von einem Tier“ in ein spezifisches Foto.
Schwach: "product photo of headphones."
Analyse: „Product photo“ benennt eine Kategorie, aber ohne Beleuchtung, Oberfläche oder Winkel — die Ausgabe wird wie ein Standard-Katalog aussehen.
Fixed:
Matte-black wireless headphones floating above a walnut surface,
single softbox from upper left creating one clean highlight on
the ear cup, deep charcoal gradient background, three-quarter
angle, commercial product photography, sharp focus
Warum es funktioniert: Oberfläche, Lichtrichtung und Kamerawinkel sind genau die Entscheidungen, auf denen ein Produktbild steht.
Schwach: "poster for a music festival."
Analyse: Keine visuelle Identität, keine Textbehandlung — und Poster leben oder sterben an der Typografie.
Fixed:
Music festival poster, bold sans-serif headline "SOUND WAVES"
centered at top, deep purple-to-black gradient background,
a single white line-art wave motif across the middle, small
date line "JULY 18" at the bottom edge, flat modern graphic design
Warum es funktioniert: Der Text ist kurz, seine Platzierung und Schriftart sind angegeben, und das Layout hat eine Idee statt fünf. Genau hier zeigt GLMImage seine Stärke — Layouts mit Text sind seine Stärke.
Die Struktur an Ihre Disziplin anpassen
Porträts. Identität und Licht sind alles: Alter und Charakterlinien, Ausdruck, Blickrichtung ("direkter Blickkontakt", "Blick nach links aus dem Bild"), Objektiv ("85mm f/1.4" für schmeichelhafte Kompression) und eine Hintergrundentscheidung ("einfaches Studio-Grau", "verschwommenes Café-Interieur"). Für geführte Ergebnisse packt der Porträt-Generator diese Struktur für Sie.
Produkt und E-Commerce. Nennen Sie das Material und die Oberfläche ("gebürstetes Aluminium, matte Keramik"), die Inszenierung, eine dominante Lichtquelle und den Winkel. Halten Sie dann diese Vorlage über alle SKUs hinweg konstant, damit der Katalog wie ein einziger Shoot statt wie zwölf aussieht.
Illustration und technische Arbeiten. Geben Sie Medium und Linienführung an ("Federzeichnung mit Kreuzschraffur", "flacher Vektor mit 2px-Umrissen") und – für Diagramme – wie sich Beschriftungen verhalten ("klare serifenlose Beschriftungen mit Führungslinien"). Beschriftete Abbildungen sind ein Text-Rendering-Problem in Verkleidung, weshalb der wissenschaftliche Illustrations-Generator als dediziertes Tool existiert.
Poster und texttragendes Design. Anführungszeichen um den exakten Text, eine Platzierung dafür, eine Typografie-Richtung und eine bewusst kurze Wortanzahl. Das tiefergehende Playbook für Typografie in generierten Bildern finden Sie in beste KI-Text-Rendering.
Die Fehler, die Prompts leise zerstören
| Fehler | Warum es fehlschlägt | Die Lösung |
|---|---|---|
| Unklarer Gegenstand | Das Modell füllt Lücken mit Durchschnitten | Füge Epoche, Material, Umgebung, Handlung hinzu |
| Keyword-Stuffing | Wörter polieren, nichts zu polieren | Einen Stil klar angeben |
| Widersprüchlicher Stil | "Minimalistisch verschnörkelt" lenkt die Aufmerksamkeit ab | Eine Richtung pro Prompt |
| Keine Hintergrundentscheidung | Hintergrund wird zu Matsch | Gib es an, auch als "sauberer Farbverlauf" |
| Langer Text im Bild | Typesetting ist nicht die Aufgabe des Modells | Kurze Phrasen; Layout-Tool für den Text |
| Licht vernachlässigen | Licht ist das, was ein Bild lesbar macht | Immer Richtung und Qualität einbeziehen |
Die meisten davon sind dieselbe Sünde in verschiedenen Gewändern: eine Entscheidung offen zu lassen.
Iteration: So werden gute Prompts wirklich fertig
Dein erster Prompt ist ein Entwurf, und die Ausgabe diagnostisch zu lesen, ist die entscheidende Fähigkeit. Frag dich: Was genau stimmt nicht, und welche Formulierung in meinem Prompt ist für diesen Bildbereich verantwortlich? Flache Beleuchtung geht auf die Licht-Formulierung zurück; eine überladene Szene auf den Hintergrund, den du nie angegeben hast; ein langweiliger Blickwinkel auf die fehlende Kameraangabe.
Ändere dann jeweils nur eine Sache. Den ganzen Prompt nach jedem Ergebnis neu zu schreiben, setzt alle Variablen gleichzeitig zurück – du lernst nichts, und Glück lässt sich nicht reproduzieren. Eine einzelne Änderung plus ein wiederverwendeter Seed (wenn dein Tool ihn anzeigt) ist ein kontrolliertes Experiment: dasselbe Bild, ein Unterschied.
Wenn eine Generation zu 80 % stimmt, hör auf, den Prompt neu zu schreiben, und wechsle zu Image-to-Image: Verwende das Ergebnis als Referenz und gib nur die Korrektur vor („ändere den Hintergrund zu X, lass alles andere unverändert“). Die vollständige Methode findest du im GLMImage-Walkthrough, der beide Modi von Anfang bis Ende abdeckt.
Zwei Kalibrierungsgewohnheiten, die sich lohnen: Lege eine persönliche Datei mit erfolgreichen Prompts und ihren Ausgaben an; und halte fest, welche kleinen Änderungen welche Effekte bewirkt haben. Zehn Minuten Notizen verwandeln hundert Generierungen in ein privates Prompting-Handbuch.
Häufig gestellte Fragen
Wie lang sollte ein KI-Bildprompt sein?
Ungefähr 25–60 Wörter decken die meisten Aufgaben ab. Die Länge ist nicht entscheidend – die Abdeckung schon. Ein 40-Wörter-Prompt, der Motiv, Stil, Licht, Objektiv und Hintergrund festlegt, schlägt einen 120-Wörter-Prompt voller Adjektive.
Helfen Qualitäts-Keywords wie „8K, masterpiece“ wirklich?
Sie lenken das Modell in Richtung Politur und können einem bereits spezifischen Prompt helfen. Ein vages Motiv retten sie nicht – Detail-Keywords sind die Würze, nicht das Gericht.
Kann ich Prompts auf Chinesisch schreiben?
Ja. GLM-Image ist nativ bilingual, daher werden chinesische Prompts direkt verarbeitet und nicht weggübersetzt. Das ist auch der Grund, warum chinesischer Text innerhalb von Bildern so gut gerendert wird.
Warum hat derselbe Prompt ein anderes Bild ergeben?
Generierungen verwenden standardmäßig einen zufälligen Seed, sodass jeder Durchlauf ein anderes Ergebnis liefert. Verwenden Sie denselben Seed erneut – die Generierungsdetails Ihres Tools zeigen ihn in der Regel an –, um ein Ergebnis zu reproduzieren und den Prompt dann gezielt zu variieren.
Setzen Sie die Struktur um: öffnen Sie den Generator → und überarbeiten Sie Ihren letzten Prompt Block für Block.











