AI画像エディター
GLM-Imageを搭載した画像から画像への生成機能により、AIで画像の編集・変換を行います。テキストから画像を生成するツールでも使われている同じハイブリッドモデルです。
画像エディター
画像を追加
0
—
用途を探す
すべての用途を見る (9)折りたたむ
Inspiration
GLM-Imageで編集された作品
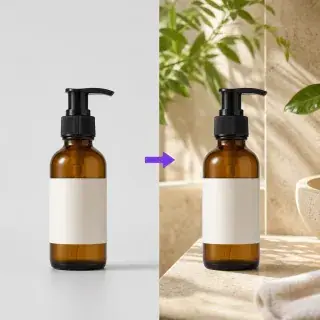
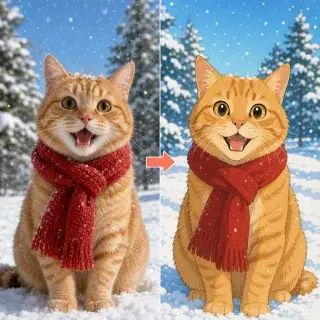
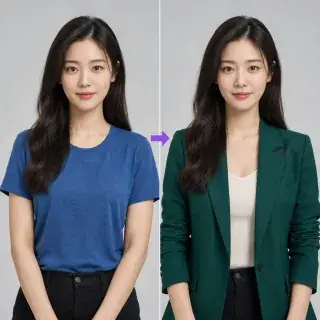
GLM-Imageの画像から画像への編集で作られた注目作品 — 任意の作品をタップしてプロンプトを確認できます。
GLM-Imageを搭載した画像から画像への生成機能により、AIで画像の編集・変換を行います。テキストから画像を生成するツールでも使われている同じハイブリッドモデルです。
Inspiration
GLM-Imageの画像から画像への編集で作られた注目作品 — 任意の作品をタップしてプロンプトを確認できます。