
Um bom prompt de imagem de IA é uma especificação, não um desejo. A fórmula confiável: nomeie o assunto com precisão, declare o estilo de forma clara e, em seguida, adicione os detalhes concretos — iluminação, câmera, paleta, composição — que o modelo adivinharia caso contrário. Tudo neste guia se baseia nessa estrutura, com exemplos de antes e depois que você pode comparar com seus próprios prompts. Os exemplos pressupõem o GLM-Image, o modelo da GLMImage, mas o método se aplica a qualquer gerador.
A ideia central: um prompt é um conjunto de decisões. Cada detalhe que você deixa sem especificar, o modelo decide por você, e seus padrões são medianos por definição. Um resultado genérico quase nunca é um problema do modelo em primeiro lugar — é um problema de prompt não especificado em primeiro lugar.
<!--IMG: The same subject generated from a vague prompt versus a structured, detailed prompt-->
Por que a maioria dos prompts de imagens de IA falha?
Eles não especificam o suficiente. "Uma cafeteria" não contém nenhuma decisão que o modelo possa usar: sem época, sem país, sem hora do dia, sem lente, sem atmosfera. O modelo resolve cada ambiguidade com a média do seu treinamento, e médias parecem tudo e nada. O resultado parece genérico porque é literalmente uma média.
Três hábitos agravantes pioram a situação. Empilhar palavras-chave de estilo sem um assunto ("masterpiece, 8K, trending on artstation, cinematic") dá ao modelo vocabulário de polimento sem nada para polir. Contradições ("minimalista, ornamentado, movimentado") dividem a atenção do modelo em ruído. E pedir texto longo dentro da imagem ("pôster com a programação completa do evento") encarrega o modelo de diagramação, o que não é o ponto forte de nenhum gerador — frases curtas são o regime confiável.
Nada disso significa escrever mais palavras. Significa escrever palavras que cada uma force exatamente uma decisão.
A estrutura por trás dos prompts que funcionam
Três blocos, nesta ordem:
[Assunto + ação] + [Estilo / meio] + [Detalhes concretos:
iluminação, câmera ou ponto de vista, paleta, fundo, composição]
Assunto mais ação responde a "do que é esta uma imagem, e o que está acontecendo." Inclua os detalhes específicos que importam para você — idade, material, cenário, época — porque eles não serão inferidos.
Estilo ou meio responde a "o que é esta uma imagem como." Fotorealista, fotografia editorial, aquarela, ilustração vetorial plana, arte conceitual isométrica. Uma escolha clara supera três misturadas.
Detalhes concretos são onde a qualidade vive. Iluminação ("hora dourada da esquerda," "softbox de estúdio com luz de contorno sutil"), ponto de vista ("lente de retrato 85mm na altura dos olhos," "ângulo largo baixo"), paleta ("tons terrosos apagados," "navy e latão"), fundo ("gradiente limpo," "rua de Osaka desfocada à noite"), composição ("sujeito no terço esquerdo," "centralizado, simétrico"). Cada frase remove um grau de liberdade.
Um exemplo de trabalho, bloco por bloco:
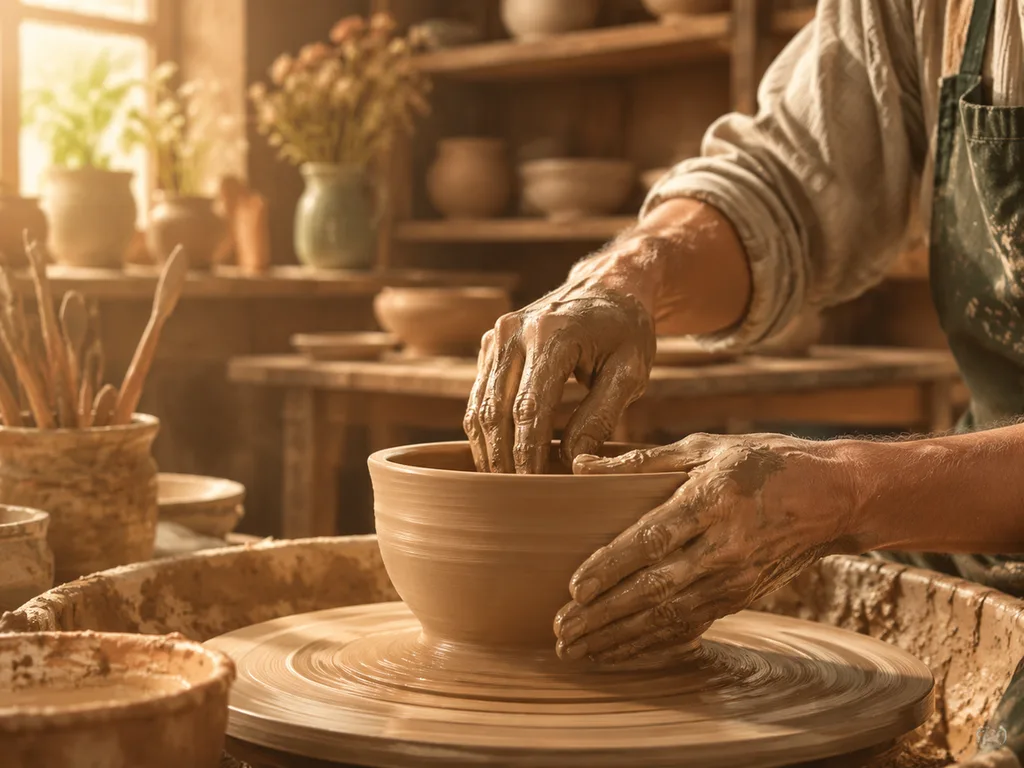
Mãos de um ceramista modelando uma tigela de barro em uma roda giratória  ← assunto + ação
Documentary photography                                       ← estilo
Warm window light from the left, shallow depth of field,
clay-dusted apron, blurred workshop shelves in the background  ← detalhes
Trinta e cinco palavras, e cada uma delas está fazendo um trabalho.
Antes e depois: três prompts fracos, corrigidos
Fraco: "a wolf in the forest."
Diagnóstico: sem estilo, sem iluminação, sem atmosfera — a floresta é a floresta média do modelo.
Fixed:
A gray wolf standing alert on a moss-covered rock in a misty
pine forest at dawn, wildlife photography, 300mm telephoto
compression, soft diffused fog, muted greens and grays,
sharp focus on the eyes
Por que funciona: as escolhas de névoa e teleobjetivo transformam sozinhas "uma foto de animal" numa fotografia específica.
Fraco: "product photo of headphones."
Diagnóstico: "foto de produto" nomeia um gênero, mas sem iluminação, superfície ou ângulo — a saída parecerá um catálogo padrão de estoque.
Fixed:
Matte-black wireless headphones floating above a walnut surface,
single softbox from upper left creating one clean highlight on
the ear cup, deep charcoal gradient background, three-quarter
angle, commercial product photography, sharp focus
Por que funciona: a superfície, a direção da luz e o ângulo da câmera são exatamente as decisões que uma foto de produto se apoia.
Fraco: "poster for a music festival."
Diagnóstico: sem identidade visual, sem manipulação de texto — e os pôsteres vivem ou morrem na tipografia.
Fixed:
Music festival poster, bold sans-serif headline "SOUND WAVES"
centered at top, deep purple-to-black gradient background,
a single white line-art wave motif across the middle, small
date line "JULY 18" at the bottom edge, flat modern graphic design
Por que funciona: o texto é curto, seu posicionamento e fonte são declarados, e o layout tem uma ideia em vez de cinco. Este é também o lugar onde GLMImage ganha — os layouts com texto são sua força.
Ajustando a estrutura para a sua disciplina
Retratos. Identidade e luz são tudo: linhas de idade e caráter, expressão, direção do olhar ("direct eye contact," "gazing off-frame left"), lente ("85mm f/1.4" para compressão lisonjeira) e uma decisão de fundo ("plain studio gray," "blurred café interior"). Para resultados guiados, o gerador de retratos empacota essa estrutura para você.
Produto e e-commerce. Nomeie o material e o acabamento ("brushed aluminum, matte ceramic"), o cenário, uma fonte de luz dominante e o ângulo. Depois, mantenha esse modelo constante em todos os SKUs para que o catálogo pareça um único ensaio fotográfico, e não doze.
Ilustração e trabalho técnico. Especifique o meio e o traço ("pen-and-ink with cross-hatching," "flat vector with 2px outlines") e — para diagramas — como os rótulos se comportam ("clear sans-serif labels with leader lines"). Figuras rotuladas são um problema de renderização de texto disfarçado, por isso o gerador de ilustrações científicas existe como uma ferramenta dedicada.
Cartazes e design com texto. Aspas em volta do texto exato, um posicionamento para ele, uma direção de tipografia e uma contagem de palavras deliberadamente curta. O guia mais aprofundado para tipografia em imagens geradas está em melhor renderização de texto com IA.
Os erros que silenciosamente estragam os prompts
| Erro | Por que falha | A solução |
|---|---|---|
| Sujeito vago | O modelo preenche os vazios com médias | Adicione era, material, cenário, ação |
| Encher de palavras-chave | Polir palavras, não há nada para polir | Um estilo, declarado claramente |
| Estilo contraditório | "Minimalista ornamentado" divide a atenção | Uma direção por prompt |
| Sem decisão de fundo | Fundo padrão para uma bagunça | Declare-o, mesmo como "gradiente limpo" |
| Texto longo dentro da imagem | A formatação de texto não é o trabalho do modelo | Frases curtas; ferramenta de layout para cópia |
| Negligenciar a luz | A luz é o que faz a imagem ser lida | Sempre inclua direção e qualidade |
A maioria desses são o mesmo pecado em roupas diferentes: deixar uma decisão sem tomar.
Iteração: como bons prompts realmente ficam prontos
O primeiro prompt é um rascunho, e a habilidade está em ler o resultado de forma diagnóstica. Pergunte: o que exatamente está errado, e qual trecho do meu prompt é responsável por aquela região da imagem? Iluminação chapada aponta para a frase de iluminação; uma cena sobrecarregada aponta para o fundo que você nunca especificou; um ângulo sem graça aponta para a nota de câmera que faltou.
Depois, mude uma coisa de cada vez. Reescrever o prompt inteiro depois de cada resultado zera todas as variáveis de uma vez — você não aprende nada e não consegue reproduzir a sorte. Uma única alteração mais uma seed reutilizada (quando a ferramenta a mostra) é um experimento controlado: a mesma imagem, uma diferença.
Quando uma geração está 80% certa, pare de reescrever o prompt e passe para image-to-image: use o resultado como referência e peça só o ajuste ("mude o fundo para X, mantenha todo o resto inalterado"). O método completo está no passo a passo do GLMImage, que cobre os dois modos de ponta a ponta.
Dois hábitos de calibração que valem a pena cultivar: mantenha um arquivo pessoal de prompts que funcionaram, com os respectivos resultados; e registre quais pequenas edições produziram quais efeitos. Dez minutos de anotações transformam cem gerações em um manual pessoal de prompting.
Perguntas frequentes
Qual deve ser o tamanho de um prompt de imagem de IA?
Cerca de 25–60 palavras cobrem a maioria dos trabalhos. O comprimento não é a variável — a cobertura é. Um prompt de 40 palavras que define assunto, estilo, luz, lente e fundo supera um prompt de 120 palavras recheado de adjetivos.
Palavras-chave de qualidade como "8K, masterpiece" realmente ajudam?
Elas inclinham o modelo para um acabamento mais polido e podem ajudar um prompt que já é específico. Não resgatam um assunto vago — palavras-chave de detalhe são o tempero, não o prato.
Posso escrever prompts em chinês?
Sim. O GLM-Image é nativamente bilíngue, então prompts em chinês são processados diretamente, sem tradução intermediária. É também por isso que ele renderiza tão bem o texto chinês dentro das imagens.
Por que o mesmo prompt gerou uma imagem diferente?
As gerações usam uma semente aleatória por padrão, então cada execução amostra um resultado diferente. Reutilize a semente — os detalhes de geração da sua ferramenta geralmente a exibem — para reproduzir um resultado e, em seguida, variar o prompt de forma deliberada.
Coloque a estrutura em prática: abra o gerador → e reescreva seu último prompt bloco a bloco.











