
良いAI画像プロンプトは、願望ではなく仕様である。確実な公式はこうだ。被写体を正確に指定し、スタイルをはっきり述べ、そのうえで照明、カメラ、配色、構図といった、モデルがさもなければ推測してしまう具体的なディテールを加える。このガイドのすべてはこの構造の上に組み立てられており、自分のプロンプトと見比べられるビフォー・アフターの例を載せている。例はGLMImageのモデルであるGLM-Imageを前提としているが、この方法はどの生成モデルにも通用する。
核心はこうだ。プロンプトとは判断の集合である。指定しなかったディテールはすべて、モデルが代わりに決める。そしてそのデフォルトは、定義上、平均的なものだ。凡庸な出力は、まずモデルの問題であることはほとんどない——まず、プロンプトが未指定であることの問題なのだ。
<!--IMG: 曖昧なプロンプトと、構造化された詳細なプロンプトから生成した同じ被写体-->
なぜほとんどのAI画像プロンプトは失敗するのか?
具体性が足りないのだ。「A coffee shop」にはモデルが使える判断材料が一切ない。時代も、国も、時間帯も、レンズも、雰囲気も指定されていない。モデルはそれぞれの曖昧さを学習データの平均で埋める。平均はあらゆるものに見え、同時に何ものにも見えない。結果が汎用的に感じられるのは、文字通り平均だからだ。
状況をさらに悪化させる3つの悪い習慣がある。主題なしにスタイルキーワードを積み重ねる(「masterpiece, 8K, trending on artstation, cinematic」)と、モデルには磨く対象のない磨きの語彙だけが与えられる。矛盾した指定(「minimalist, ornate, busy」)はモデルの注意をノイズへと分散させる。そして画像内に長いテキストを求める(「poster with the full event schedule」)と、モデルに組版を強いることになる。これはどの生成モデルの強みでもない——短いフレーズこそが信頼できる領域だ。
これは言葉を増やせばいいという意味ではない。一つひとつの言葉が正確に一つの判断を強制することを意味する。
プロンプトが機能する構造
Three blocks, in this order:
[Subject + action] + [Style / medium] + [Concrete details:
照明、カメラアングルや視点、パレット、背景、構成]
Subject plus action は「これは何の画像で、何が起こっているか」を答えています。あなたにとって重要な具体的な詳細(年齢、素材、設定、時代など)を含めてください。それらは推測されません。
Style or medium は「これは何の画像として」という答えです。フォトリアリスティック、編集写真、水彩画、フラットベクターイラスト、アイソメトリックコンセプトアートなど。一つの明確な選択が三つのブレンドされたものより優れています。
Concrete details は品質の所在です。照明(「左からのゴールデンアワー」、「サブティルリムライトのスタジオソフトボックス」)、視点(「アイレベルでの85mmポートレンズ」、「ロー広角」)、パレット(「マットなアーストーン」、「ネイビーとブラス」)、背景(「クリーンなグラデーション」、「夜の大阪のぼやけた街」)、構成(「被写体を左の3分の1に」、「中央で対称」)。各フレーズは1つの自由度を除去します。
A worked example, block by block:
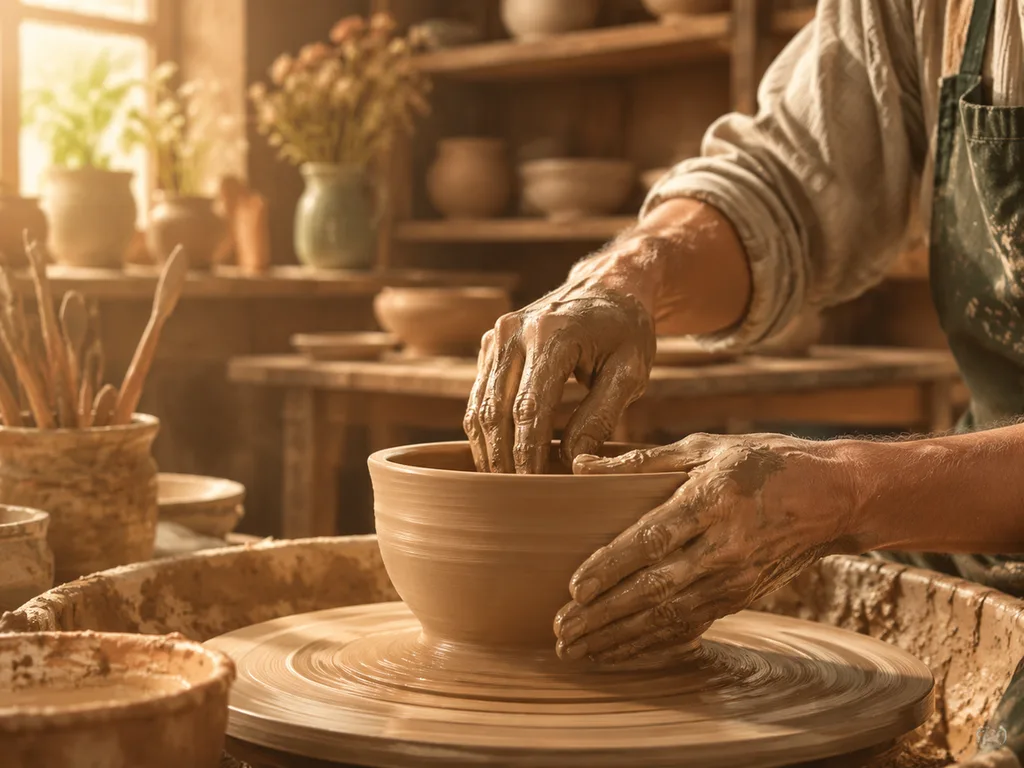
セラミック作家の手がスピニングホイールで粘土のボウルを成形している ← subject + action
ドキュメンタリーフォトグラフィー ← style
左からの暖かい窓の光、浅い被写界深度、粘土の埃が付いたエプロン、背景にぼやけた作業場棚 ← details
35語で、それぞれが役割を果たしています。
弱いプロンプト3つを改善した前後
弱いプロンプト: 「a wolf in the forest.」
問題点: スタイルも光もムードもない — 森はモデルの平均的な森のまま。
修正後:
A gray wolf standing alert on a moss-covered rock in a misty
pine forest at dawn, wildlife photography, 300mm telephoto
compression, soft diffused fog, muted greens and grays,
sharp focus on the eyes
効果的な理由: 霧とテレフォトの選択だけで「動物の写真」という表現を具体的な写真に変えてくれる。
弱いプロンプト: 「product photo of headphones.」
問題点: 「product photo」はジャンル名だが、照明・表面・角度の指定がない — 出力は在庫カタログのデフォルトのように見える。
修正後:
Matte-black wireless headphones floating above a walnut surface,
single softbox from upper left creating one clean highlight on
the ear cup, deep charcoal gradient background, three-quarter
angle, commercial product photography, sharp focus
効果的な理由: 表面、照明の方向、カメラアングルは、製品写真の基盤となる正確な決定だ。
弱いプロンプト: 「poster for a music festival.」
問題点: 視覚的アイデンティティもテキスト処理もない — ポスターはフォントで決まる。
修正後:
Music festival poster, bold sans-serif headline "SOUND WAVES"
centered at top, deep purple-to-black gradient background,
a single white line-art wave motif across the middle, small
date line "JULY 18" at the bottom edge, flat modern graphic design
効果的な理由: テキストが短く、その配置とフォントが指定され、レイアウトが一つのアイデアで五つではない。これがGLMImageの真価を発揮するところだ — テキストを含むレイアウトはGLMImageの強みだ。
分野に合わせた構造のチューニング
ポートレート。 アイデンティティと光がすべてです。年齢と個性を表すライン、表情、視線の方向(「direct eye contact」「gazing off-frame left」)、レンズ(魅力的な圧縮のための「85mm f/1.4」)、背景の決定(「plain studio gray」「blurred café interior」)。ガイド付きの結果を得るには、ポートレートジェネレーターがこの構造をパッケージ化してくれます。
製品・Eコマース。 素材と仕上げを指定します(「brushed aluminum, matte ceramic」)、ステージング、主要な光源1つ、アングル。そのテンプレートをSKU全体で一定に保ち、カタログが12回の撮影ではなく1回の撮影のように見えるようにします。
イラストレーションと技術作業。 媒体と線画を指定します(「pen-and-ink with cross-hatching」「flat vector with 2px outlines」)。図の場合は、ラベルの振る舞い(「clear sans-serif labels with leader lines」)。ラベル付きの図は、実はテキストレンダリングの問題であり、それが科学イラストジェネレーターが専用ツールとして存在する理由です。
ポスターとテキストを含むデザイン。 正確なコピーを引用符で囲み、その配置、タイポグラフィの方向、意図的に短い単語数を指定します。生成画像におけるタイポグラフィのより深いプレイブックは、best AI text renderingにあります。
プロンプトを静かに破壊するミス
| ミス | なぜ失敗するのか | 対処法 |
|---|---|---|
| 曖昧な被写体 | モデルは平均値で穴を埋める | 時代、素材、設定、アクションを追加 |
| キーワードの詰め込み | 言葉を磨く必要はない | 1つのスタイルをはっきり述べる |
| 矛盾するスタイル | 「ミニマリストで華美」 は注意を分散させる | プロンプトごとに1つの方向を指定 |
| 背景決定なし | 背景はデフォルトでぐちゃぐちゃになる | 明示的に述べる、「クリーンなグラデーション」でも |
| 画像内の長いテキスト | レイアウトはモデルの仕事ではない | 短いフレーズ;コピー用のレイアウトツール |
| 照明を無視 | 光が画像を読みやすくする | 常に方向と品質を含める |
これらはほとんどが同じ罪の別バージョンだ:決定を放置すること。
イテレーション:良いプロンプトはこうして完成する
最初のプロンプトは下書きです。出力を診断的に読み解くことこそがスキルです。問いかけましょう。具体的に何がおかしいのか、そして画像のその領域を担っているのは、自分のプロンプトのどのフレーズなのか? 平坦なライティングはライティングのフレーズに、散らかったシーンは指定しなかった背景に、退屈なアングルは欠けているカメラ指定に、それぞれ原因を遡れます。
それから、一度に一つだけ変えます。結果が出るたびにプロンプト全体を書き直すと、すべての変数が一度にリセットされてしまいます——何も学べず、まぐれ当たりを再現することもできません。一つの変更と、再利用したシード(ツールが表示する場合)の組み合わせは、対照実験です。同じ画像で、違いは一つだけ。
生成結果が8割正しいなら、プロンプトのやり直しをやめて image-to-image に切り替えましょう。結果を参照画像として戻し、修正箇所だけを指示します(「背景をXに変えて、それ以外はすべてそのまま」)。完全な方法は GLMImage ウォークスルー にあり、両方のモードを最初から最後までカバーしています。
身につけておきたいキャリブレーションの習慣が二つあります。うまくいったプロンプトとその出力を個人用ファイルに残すこと。そして、どの小さな編集がどの効果を生んだかを記録すること。10分のメモが、100回の生成を自分専用のプロンプトマニュアルに変えます。
よくある質問
AI画像プロンプトはどのくらいの長さが適切ですか?
だいたい25〜60語でほとんどの作業をカバーできます。重要なのは長さではなく、カバー範囲です。被写体、スタイル、光、レンズ、背景を決めた40語のプロンプトは、形容詞ばかりの120語のプロンプトに勝ります。
「8K, masterpiece」のような品質キーワードは本当に効果がありますか?
モデルを洗練された仕上がりに誘導し、すでに具体的なプロンプトには効果があります。曖昧な被写体を救うことはできません——詳細キーワードは味付けであって、メインディッシュではありません。
中国語でプロンプトを書けますか?
はい。GLM-Imageはネイティブにバイリンガルなので、中国語のプロンプトは翻訳されずに直接処理されます。画像内の中国語テキストがきれいに描画されるのも、これが理由です。
同じプロンプトなのに違う画像が出たのはなぜですか?
生成はデフォルトでランダムシードを使うため、実行するたびに異なる結果がサンプリングされます。結果を再現するにはシードを再利用し——ツールの生成詳細に通常表示されます——そのうえでプロンプトを意図的に変えてください。
この構成を実践しましょう:ジェネレーターを開く → 直近のプロンプトをブロックごとに書き直してください。











